
上一篇聊完了意圖分析,知道使用者問的問題該往哪個方向查。但在那之前,其實有一件更基礎、也更容易被低估的事情 — 你的資料到底要怎麼「切」、怎麼「向量化」。這件事沒做好,意圖分析再準、ReRank 再強,撈回來的東西還是不對,整個 RAG 就是地基歪掉。
這篇先把 RAG Agent 整體架構講一遍,再一項一項拆開細節。
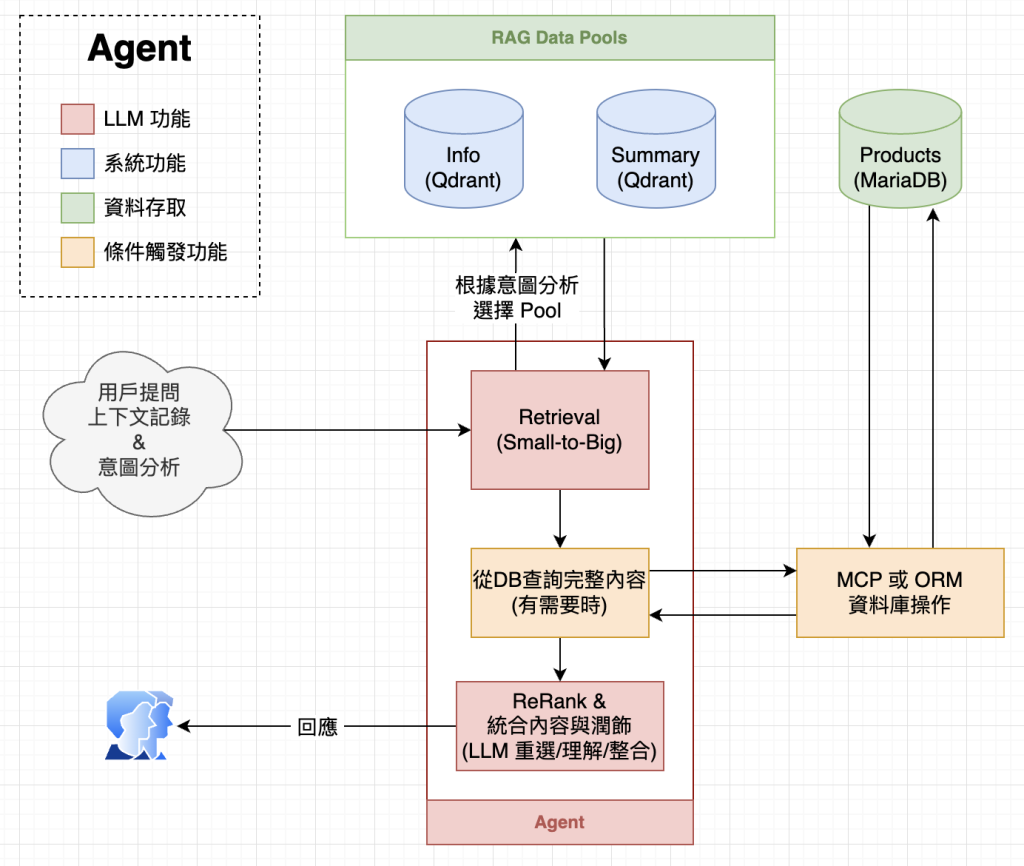
資料層分成三塊:
圖中 Retrieval (Small-to-Big) 呼應的正是 LlamaIndex 裡 Sentence Window Retrieval(Metadata Replacement) 這個技巧背後的精神:
向量比對用「小」的單位做(因為小單位的語意向量比較精準、不會被稀釋),但真正要組出回答時,回頭抓「大」的完整內容給 LLM 看。
LlamaIndex 官方的具體做法是:用 SentenceWindowNodeParser 把文件拆成一句一句(node),每個 node 只拿單一句子去做 embedding;同時每個 node 的 metadata 裡都存一個「window」——前後各幾句的完整上下文(句數可自行設定)。檢索的時候,比對的是那顆最精準的單句向量;命中之後,再用 MetadataReplacementPostProcessor 把單句換成完整的 window,最後才丟給 LLM 生成答案。
為什麼要這樣拆?因為如果直接拿一大段文字去 embedding,向量其實是整段文字語意:「較長的文字容易稀釋特定關鍵字的訊號」,遇到像特定專有名詞這種很具體的關鍵字,反而容易被稀釋、比對不精準;但如果只拿單句去比對,命中率會明顯提升 — LlamaIndex 官方 demo 就示範過,同一個問題,句子級索引答得出來,段落級索引(chunk 切太大)反而答不出來,除非把 top_k 硬拉高。
回到架構圖:Info / Summary(Qdrant)扮演的就是「小單位、精準比對」的角色,而 MariaDB(Products)扮演的是「補回大內容」的角色——只是「補大」的方式不是靠 node metadata 裡存的 window,而是直接回查資料庫抓完整、結構化的原始資料。概念上是同一套 Small-to-Big 精神,只是把「句子 vs. 句子窗口」換成了「向量摘要 vs. 資料庫完整內容」這種更粗的顆粒度,實作載體不同而已。
理解這個大方向之後,接下來拆兩個主題:怎麼切(Chunking)、怎麼向量化(Embedding)。
不同來源的資料,切法不會一樣:
結構化清楚的文件(有標題、章節的技術文件、SOP)→ 適合照結構切
一大坨敘述性文字(產品介紹、FAQ 長文)→ 適合語意或固定長度切
表格、規格資料 → 通常不切文字,而是轉成結構化欄位另外處理(這也是為什麼圖上 Products 是另外一個 MariaDB,而不是塞進向量庫)
先分類資料型態,再決定切法,而不是全部套同一套規則硬切,這是最容易被忽略但影響最大的一步。
| 切法 | 概念 | 優點 | 缺點 |
|---|---|---|---|
| 固定長度切分 | 每 N 個字/token 切一刀 | 簡單好實作 | 常常把一句話從中間切斷,語意破碎 |
| Recursive 遞迴切分 | 先照段落/句子切,長度超過上限才往下細切 | 比固定長度自然一點 | 還是可能切到語意邊界上 |
| 語意切分(Semantic) | 用 embedding 相似度判斷「這段跟下一段像不像」,像的留一起 | 有機會提升語意完整度 | 運算成本較高,慢 |
| 結構感知切分 | 依 Markdown 標題、HTML 標籤、章節編號切 | 天然對齊文件邏輯 | 依賴資料本身有清楚結構 |
SentenceWindowNodeParser 把文件拆到「句子」這麼細的粒度,一句一個 nodeMetadataReplacementPostProcessor 把單句換成完整 window,再丟給 LLM這個做法的「大 / 小」是在同一個 index 裡、靠 metadata 切換完成的,不需要另外查資料庫。
這個做法的「大 / 小」是預先切好、分層儲存的,檢索到小的之後,用 ID 去換回大的——這正是你架構圖裡「從 DB 查詢完整內容(有需要時)」在做的事。
小提醒:這兩種做法不是互斥的,甚至可以疊加——例如 child chunk 內部也用句子級拆分去產生更細的候選,再視情況決定要不要拉到 parent。實務上通常先選一種做基礎版本,跑出問題再考慮要不要疊加。
以下抓的是**做法二(Parent-Child/DB 回查)**的經驗值;如果走 Sentence Window,「chunk size」這個概念基本不存在,要調的是句子拆分品質跟 window 要抓幾句,邏輯不太一樣,抓法會另外談。
沒有絕對正確的數字,但可以抓一個經驗起點再慢慢調:
Child chunk:大約 300~500 tokens,overlap 抓 10~20%(例如 50~100 tokens),避免切在句子中間造成語意斷裂
Parent chunk:以「一個小節」或「一個完整主題」為單位,不特別限制固定字數
判斷標準只有一個:這個 chunk 單獨拿出來看,人類看得懂在講什麼嗎?看不懂,代表切太碎了
每個 chunk 存進 Qdrant 的時候,一定要附上:
因為使用者問問題的「顆粒度」本來就不一樣。有人問很細節的規格問題,適合去 Info Pool 精準比對;有人問「幫我整理一下這個產品系列大概是什麼」,這種概略性問題丟到細碎的 Info chunk 裡反而比不準,交給 Summary Pool(每個 parent 先用 LLM 產生一段摘要再向量化)會準得多。
這也解釋了架構圖上「根據意圖分析選擇 Pool」那條線——意圖分析的產出,其實就是在幫檢索階段決定「這次要用哪把尺去量」。
這塊選型會隨時間一直變動,但決策邏輯大致固定,抓幾個維度來想:
地端 vs API:這個系列講的是地端 AI 架構,如果資料敏感或希望完全掌控成本,開源、可以本機/內網跑的模型會是首選;如果不介意資料出網,API 型的模型通常開發體驗比較省事。
語言支援度:中文(尤其繁體)場景要特別測過,不能只看英文評測榜單就選型,因為很多榜單是以簡體語料為主,繁體表現不一定對等。
文本長度:長文件、長段落多的話,要挑對長文本支援較好的模型,不然超長 parent chunk 會被截斷。
以目前(2026 年)的大方向來說,開源陣營裡 BGE-M3 這類多語言模型是地端部署很常見的起手式,成本可控、多語言覆蓋廣;如果對中文檢索品質要求更高、也有足夠算力,Qwen 系列的 Embedding 模型近期在中文評測上表現相當亮眼,但相對更吃資源。
向量維度越高,理論上語意保留越完整,但儲存空間和檢索速度的代價也越大。有些新一代模型支援「降維」(例如 Matryoshka 表示法),可以把向量維度砍到一半甚至更低,換來大幅節省儲存空間,品質損失通常在可接受範圍內——但降多少會開始明顯影響準確率,一定要自己測,不要憑感覺設。
Query 端跟 Document 端一定要用同一個 embedding 模型,依該模型規範分別處理 Query 與 Document去產生向量,兩邊對不齊,相似度算出來就是亂的。更麻煩的是,如果之後想換模型(例如換一個評測分數更高的新模型),代表 Qdrant 裡所有既有的向量都要重新算過一次,這是不小的工程成本,選型階段就該想清楚,不要之後才後悔。
把上面講的串成一個實際的處理流程:
- 文件前處理:清洗雜訊(頁首頁尾、亂碼、重複段落),統一格式
- Parent chunk 切分:依文件結構切出大塊,保留完整語意
- Child chunk 切分:從每個 parent 再細切,附上 overlap
- (可選)產生摘要:對每個 parent 呼叫 LLM 產生摘要文字,準備進 Summary Pool
- Embedding:child chunk → 向量 → 寫入 Info(Qdrant);摘要文字 → 向量 → 寫入 Summary(Qdrant)
- 寫入 Metadata:每筆向量都帶上來源 ID、parent ID、對應 MariaDB 主鍵
- 完整內容落地:原始/結構化內容存進 MariaDB(Products),供 Small-to-Big 回查使用


 iThome鐵人賽
 看影片追技術